


Это перевод оригинальной статьи — Using AI and Machine Learning to Overcome Position Bias within Adobe Stock Search by Fengbin Chen
В цифровой розничной торговле это может быть как ключевым преимуществом, так и существенной проблемой: огромный объем товаров, доступных потенциальному покупателю в любой момент времени. В мире, где выбор кажется бесконечным, релевантность и ранжирование в поисковой выдаче играют важную роль в демонстрации разнообразия доступных товаров и, в конечном итоге, в побуждении покупателей выбрать то, что соответствует их потребностям. Покупатели редко прокручивают результаты поиска или переходят дальше первой страницы, чтобы найти то, что им нужно. Это еще важнее для нас в Adobe Stock — маркетплейсе контента, насчитывающем более 900 миллионов ресурсов, поскольку наш уникальный бизнес требует от нас несколько иного подхода к релевантности и ранжированию, чем в типичном бизнесе электронной коммерции.
Во-первых, наша бизнес-модель предполагает предоставление подписок. Подписчики часто возвращаются, чтобы выполнять одни и те же поисковые запросы с разными целями, поэтому контент, отображаемый вверху результатов, не должен оставаться неизменным. Кроме того, мы продаем цифровые, а не физические товары, и клиенты часто используют загруженный контент не только для собственных нужд, но и для поиска вдохновения, которое они смогут использовать в своих проектах. Наконец, в мире стокового контента, в отличие от традиционной розничной торговли, популярные товары никогда не распродаются. Загруженный и одобренный контент обычно доступен в течение длительного времени, что делает еще более важным обеспечение разнообразия результатов для клиентов.
Изучая исторические результаты поиска по запросу на Adobe Stock, мы обнаружили, что они практически не меняются. Мы увидели, что одни и те же популярные изображения всегда остаются на вершине. Эта нехватка динамики может негативно сказаться на удобстве использования нашей платформы для обеих сторон. Наши конечные пользователи нуждаются в различных, высококачественных, популярных изображениях, которые меняются со временем. Что касается авторов, то если их недавно загруженные изображения не попадают в топ результатов, им становится сложнее монетизировать свою работу.
Поэтому для обоих наших клиентов на торговой площадке было важно повысить разнообразие результатов, генерируемых алгоритмом ранжирования поиска.
Анализ предвзятости позиции
Мы начали с анализа вовлеченности по позициям, чтобы понять, почему в наших исторических результатах не наблюдалось большого разнообразия. В качестве сравнительного показателя мы использовали коэффициент загрузок (DTR), который представляет собой количество загрузок, нормализованное по количеству показов на каждой позиции. На веб-сайте Adobe Stock мы отображаем 100 изображений на странице, а вовлеченность на каждой позиции среди первых нескольких страниц показана на следующем графике.
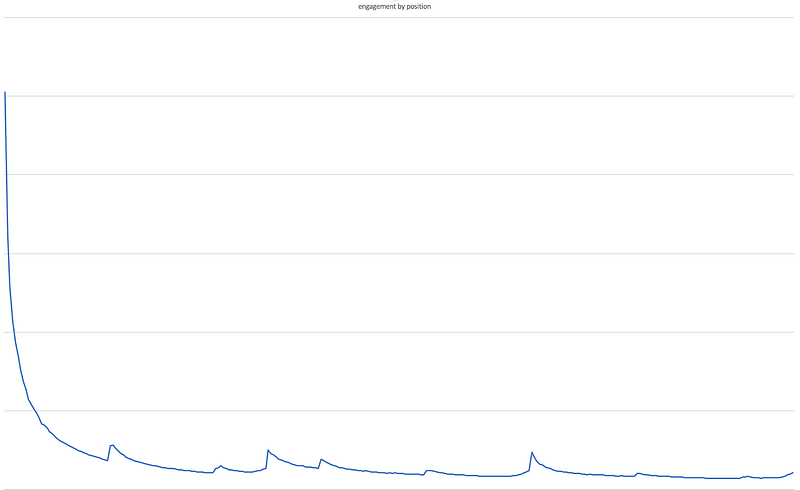
Как видно из графика, показатель DTR экспоненциально снижается с каждой позицией. Фактически, изображения на первой позиции имели более чем в десять раз больше загрузок, чем изображения на тридцатой позиции на первой странице, и примерно половина загрузок пришлась на верхнюю треть первой страницы. Обратите внимание, что периодические пики на графике частично вызваны постраничной навигацией.
Этот экспоненциальный спад можно объяснить одной из двух причин:
1. Смещение в сторону позиции, то есть клиенты с большей вероятностью будут скачивать изображения, расположенные в верхних позициях, чем изображения в нижних позициях, независимо от качества и релевантности изображения.
2. Изображения, расположенные в верхних позициях, превосходят изображения, расположенные в нижних позициях, по релевантности и качеству.
Мы полагали, что это экспоненциальное снижение в основном вызвано смещением позиции, поскольку мы обнаружили, что релевантность и качество не сильно меняются в верхних результатах. Чтобы подтвердить эту гипотезу, мы реализовали версию стандартного алгоритма EM, описанного в статье «Position Bias Estimation for Unbiased Learning to Rank in Personal Search» от Google. Этот алгоритм машинного обучения, получив запрос, определяет изменение вовлеченности при показе одного и того же изображения на разных позициях. Мы запустили его на данных о покупках и показах за год. На следующем графике показана склонность к ранжированию в зависимости от позиции, полученная алгоритмом EM на основе поведения покупателей. Как мы видим, если мы показываем одно и то же изображение на более низких позициях для одного и того же запроса, вовлеченность значительно снижается.
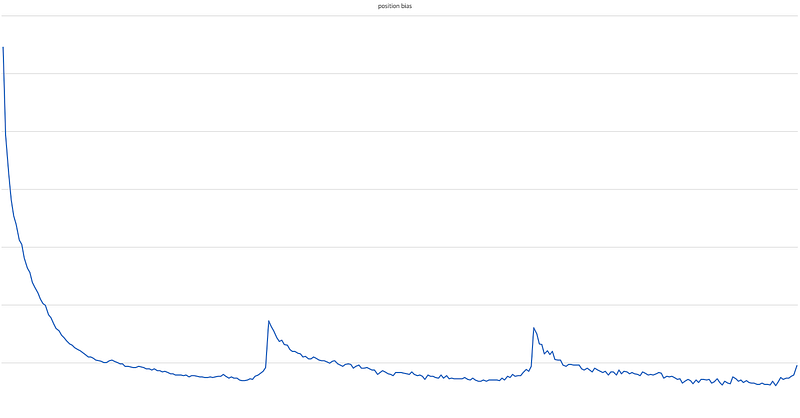
Как показано на графике, мы обнаружили значительную предвзятость в отношении позиций на сайте Adobe Stock. Наши клиенты, как правило, загружают изображения в верхней части результатов с минимальным прокручиванием, что аналогично предвзятости в отношении позиций, наблюдаемой в веб-поиске, где пользователи чаще кликают на верхние результаты. Однако мы не ожидали такой экспоненциальной предвзятости в отношении позиций, поскольку люди обрабатывают изображения гораздо быстрее, чем описания веб-страниц. Кроме того, как указано в этом недавнем исследовании , в средах электронной коммерции люди обычно прокручивают страницу и кликают на товары, расположенные гораздо ниже, чем в веб-поиске. Другие сходства, которые мы обнаружили с веб-поиском, заключаются в том, что наши клиенты чаще загружают 100-е изображение (последнее изображение), чем 95-е изображение на первой странице, и если они переходят на вторую страницу, то чаще покупают верхние результаты на второй странице, чем нижние результаты на первой.
Поэтому мы решили попробовать адаптировать методы ранжирования, используемые для веб-поиска, к нашему случаю. После того, как мы рассчитали смещение позиции, мы удалили его из обучающих данных и обучили модель непредвзятого ранжирования. Аналогично подходу, описанному в статье «Unbiased Learning-to-Rank with Biased Feedback», мы использовали метод попарного обучения ранжированию и включили обратное взвешивание склонности w в попарную (p означает положительный, n — отрицательный) функцию потерь маржи:
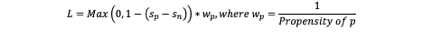
Мы также добавили в систему ранжирования новую функцию, называемую несмещенным DTR. Идея заключалась в нормализации количества покупок не только по количеству показов, но и по позиции каждого показа. Например, если изображение отображается на первой позиции, мы засчитаем один показ, а если на тридцатой — только одну пятую часть показа, поскольку вероятность покупки на первой позиции в пять раз выше, чем на тридцатой.
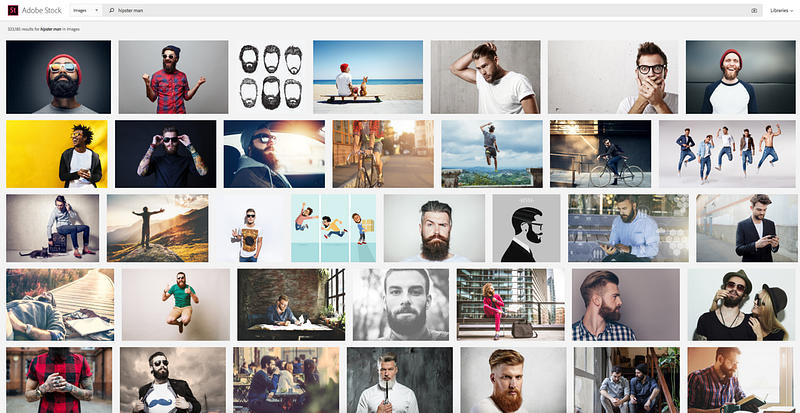
Этот алгоритм ранжирования, разработанный с использованием методов машинного обучения, помог нам увеличить разнообразие результатов по сравнению с предыдущим алгоритмом, используемым в работе. Половина результатов нового алгоритма отличается на первой странице от результатов старого. Кроме того, сайт выглядит намного свежее и динамичнее. Интересное обновление, которое мы заметили, — это отражение одного из прогнозируемых нами визуальных трендов 2019 года — креативной демократии — в обновленных результатах поиска. Благодаря большему разнообразию результатов мы видим больше ярких цветовых акцентов и вариаций в элементах дизайна, чем раньше (см. ниже):
До:
После:
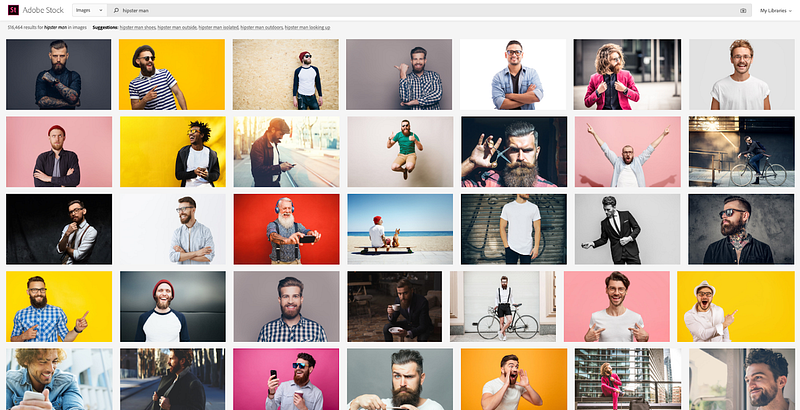
Наш анализ призван изменить ситуацию к лучшему, повысив разнообразие и актуальность изображений, которые вы увидите при использовании Adobe Stock. Мы знаем, что сейчас существует растущее давление в плане быстрого поиска и использования оригинальных, эффективных изображений в кампаниях электронной коммерции, и для авторов Adobe Stock ваши работы заслуживают того, чтобы их увидели и купили те, кто в них нуждается.
Аналитику продаж, темы для съёмки на основе реальных данных и закрытые материалы я публикую на Boosty. Если хотите находить ниши, которые ещё продаются, присоединяйтесь.
Последнее изменение: 16 октября 2026 в 18:28.
